
CSV 한글 깨짐 고치기
한글이 ‘ì´ë¦„’이나 ‘�̸�’처럼 보이면 인코딩이 맞지 않는 거예요. 원본을 올바르게 읽은 뒤 원하는 인코딩으로 다시 저장해요.
어느 쪽이 제대로 보이나요?
CSV 인코딩 변환, 깨진 한글을 판단하는 기준
언제 쓰나요
홈택스·은행·쇼핑몰 관리자 화면에서 받은 CSV를 열었더니 한글이 외계어처럼 보일 때, 반대로 내가 만든 UTF-8 파일을 오래된 사내 프로그램에 올렸더니 거부당할 때 이 도구로 저장 방식만 바꿔요. 내용은 그대로 두고 한글을 숫자로 적는 규칙(인코딩)과 줄바꿈 방식만 다시 맞춰 저장해요.
사용 방법
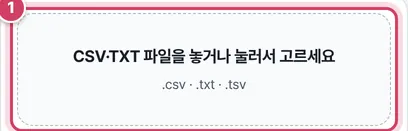
1단계파일 놓기
- 1① CSV·TXT·TSV 파일을 놓아요. 파일 내용은 고치지 않고 바이트 그대로 읽어 들여요.
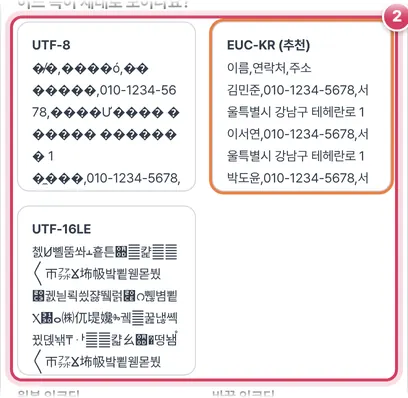
2단계제대로 보이는 쪽 고르기
- 2② 같은 파일을 UTF-8, EUC-KR, UTF-16 세 방식으로 읽은 앞 300자를 나란히 보여 줘요. 주황 테두리와 ‘추천’이 붙은 쪽이 기본으로 골라져 있고, 다른 상자를 누르면 원본 인코딩이 그쪽으로 바뀌어요.
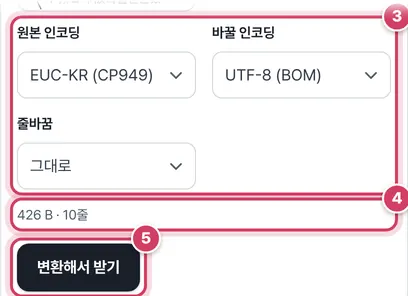
3단계바꿀 방식 정하고 받기
- 3③ 원본이 UTF-8로 판정되면 바꿀 인코딩이 EUC-KR로, 그 밖이면 UTF-8(BOM)으로 미리 골라져 있어요.
- 4④ 파일 크기와 줄 수가 나오고, EUC-KR로 바꿀 때 담을 수 없는 글자가 있으면 그 개수를 알려 줘요.
- 5⑤ 받은 파일 이름 끝에 _UTF8BOM, _UTF8, _EUCKR가 붙어 원본과 섞이지 않아요.
추천을 고르는 방법
세 가지로 읽은 글마다 점수를 매겨 가장 높은 쪽을 추천해요. 완성형 한글 한 글자는 +1점, 읽지 못해 생긴 � 기호는 −5점, UTF-8을 잘못 읽을 때 자주 보이는 ì·ë·Ã 같은 글자는 −3점이에요. 한글이 많이 보이고 깨진 흔적이 적은 쪽이 이기는 셈이에요.
| 저장 규칙 | ‘이름’의 바이트 | 다른 규칙으로 잘못 읽으면 |
|---|---|---|
| UTF-8 | EC 9D B4 EB A6 84 (6바이트) | ì´ë¦„ 같은 라틴 문자 |
| EUC-KR | C0 CC B8 A7 (4바이트) | �̸� 같은 깨진 기호 |
같은 이유로 한글이 많은 파일은 UTF-8로 바꾸면 용량이 커지고 EUC-KR로 바꾸면 작아져요. 한글 한 글자가 UTF-8에서는 3바이트, EUC-KR에서는 2바이트이기 때문이에요.
안내 줄의 줄 수는 고른 원본 인코딩으로 읽은 글을 줄바꿈 기준으로 센 값이에요. 맨 끝에 빈 줄이 하나 있는 파일은 실제 데이터 줄보다 하나 많게 나올 수 있어요.
주의할 점
- 추천이 틀릴 때 — 한글이 거의 없는 영문·숫자 위주 파일은 세 방식의 점수가 비슷해서 엉뚱한 쪽이 추천될 수 있어요. 상자 속 글을 눈으로 확인하고 직접 고르세요.
- 물음표로 바뀌는 글자 — EUC-KR에 없는 이모지 같은 글자는 ? 한 글자로 바뀌어 저장돼요. 안내 줄에 개수가 나오면 UTF-8 쪽으로 저장하는 편이 안전해요.
- 줄바꿈 ‘그대로’ — 원래 줄바꿈을 건드리지 않아요. 윈도우 메모장이나 엑셀에 올릴 파일이면 CRLF, 서버나 프로그램에 넣을 파일이면 LF를 고르면 무난해요.
도움말어느 쪽이 맞는지 헷갈리면 상자 속에서 이름·주소처럼 한글이 들어간 칸을 찾아 보세요. 맞는 인코딩에서는 한글이 자연스럽게 읽히고, 틀린 쪽에서는 영문 기호나 �가 섞여 보여요.
더 궁금한 점
원본 파일 앞에 붙어 있던 BOM은 어떻게 되나요?
읽을 때 떼어 내고, 바꿀 인코딩이 UTF-8(BOM)일 때만 새로 붙여요. 그래서 BOM이 두 번 겹쳐 붙는 일은 없어요.
확장자도 바뀌나요?
원래 확장자를 그대로 써요. .txt로 올린 파일은 .txt로 받아요.
UTF-16 상자는 언제 맞나요?
일부 프로그램이 ‘유니코드 텍스트’로 내보낸 파일이 UTF-16이에요. 이런 파일을 UTF-8이나 EUC-KR로 읽으면 글자 사이에 빈칸이나 이상한 기호가 끼어 보이니, 그때 UTF-16 상자를 골라요.
줄바꿈 방식만 바꾸고 인코딩은 그대로 둘 수 있나요?
원본과 같은 인코딩을 바꿀 인코딩으로 고르고 줄바꿈만 CRLF나 LF로 정하면 돼요. UTF-8 원본이라면 BOM 여부까지 원래대로 맞춰 고르세요.
한글이 깨지는 이유
컴퓨터는 글자를 숫자(바이트)로 저장하는데, 한글을 숫자로 바꾸는 규칙(인코딩)이 두 가지가 널리 쓰여요. 국내 윈도우 프로그램이 오래 써 온 EUC-KR(CP949, ‘ANSI’)과 전 세계 표준인 UTF-8이에요. 저장할 때와 읽을 때 규칙이 다르면 ‘ì´ë¦„’(UTF-8을 다른 방식으로 읽음)이나 ‘�̸�’(EUC-KR을 UTF-8로 읽음)처럼 깨져요.
이 도구가 하는 일
- 파일을 세 가지 방식으로 읽어 나란히 보여 주고, 한글이 가장 자연스럽게 보이는 쪽을 추천해요. 맞는 쪽을 누르면 원본 인코딩이 정해져요.
- 원하는 인코딩으로 다시 저장해요. 엑셀에서 열 거라면 UTF-8(BOM), 옛 국내 프로그램에 올릴 거라면 EUC-KR을 고르세요.
- 줄바꿈 방식(윈도우 CRLF, 맥·리눅스 LF)도 맞출 수 있어요.
주의할 점
- EUC-KR에는 이모지, 일부 한자, ‘똠’ 같은 확장 한글 일부가 없을 수 있어요(CP949는 대부분 지원). 없는 글자는 ?로 바뀌니 미리 표시되는 개수를 확인하세요.
- 이미 한 번 잘못 저장돼 ‘?’로 바뀐 글자는 되살릴 수 없어요. 원본 파일로 다시 시도하세요.
- 파일 내용은 서버로 전송되지 않아요.
자주 묻는 질문
메모장으로 저장할 때 ‘ANSI’는 무엇인가요?
한국어 윈도우에서 ANSI는 CP949(EUC-KR 확장)를 뜻해요.
BOM이 뭐예요?
파일 맨 앞에 붙는 3바이트 표시예요. 엑셀은 이 표시가 있어야 UTF-8 CSV의 한글을 바로 인식해요. 반대로 일부 프로그램은 BOM 때문에 첫 머리글 이름이 깨지기도 해요.
엑셀 파일(xlsx)도 깨지나요?
xlsx는 내부적으로 UTF-8을 써서 인코딩 문제가 없어요. CSV·TXT 같은 텍스트 파일만 해당돼요.
함께 쓰면 좋은 도구
- CSV를 엑셀로 (한글 깨짐 없이)CSV → XLSX 변환, EUC-KR·UTF-8 자동 인식, 0으로 시작하는 번호 보존
- 엑셀을 CSV로 (UTF-8·EUC-KR 선택)XLSX → CSV, UTF-8(BOM)·EUC-KR 인코딩과 구분 기호 선택
- 문자 인코딩 변환기 (여러 파일 EUC-KR ↔ UTF-8 ↔ UTF-16, BOM·줄바꿈)TXT·SRT·SMI·HTML·소스 파일 여러 개를 한 번에 EUC-KR·UTF-8·UTF-16으로, BOM 붙이기·빼기, CRLF↔LF, ZIP으로
- 텍스트(붙여넣기)를 엑셀로카톡·메모·웹 글을 칸 나눠 엑셀로
- 사진 슬라이드쇼 영상 만들기 (천천히 줌인·줌아웃, 배경음악, MP4)사진 여러 장을 천천히 줌인·줌아웃하며 부드럽게 넘어가는 MP4 영상으로, 장면 시간·전환·화면 비율(가로·세로 쇼츠·정사각)·배경음악(끝에서 서서히 작아짐)
- 엑셀 JSON 변환 (엑셀을 JSON으로, JSON을 엑셀로)엑셀·CSV 표를 JSON 배열로, JSON을 엑셀 표로(중첩 키 펼치기)